robots.txtとAIクローラー。許可・拒否の判断基準
著者:久保木肇(株式会社ジム 代表取締役。2000年からWebサイト制作に従事、企業サイトの設計・制作・運用歴26年)
コーポレートサイトのrobots.txtで、AIクローラーを「拒否」するか「許可」するかは、会社としての方針の問題であって、技術の問題ではありません。ただし判断する前に知っておくべき事実が1つあります。AIクローラーには「学習用」と「検索・回答用」の2種類があり、拒否する対象を間違えると、学習には使われないまま、AIの回答にも引用されなくなります。この記事は、コーポレートサイトの運用担当者と、robots.txtを触る制作会社・情シス担当者に向けて、主要なAIクローラーの種類と役割、拒否したときに起きること、判断のフローチャート、記述例、確認方法を解説します。
用語の定義
クローラーとは、Webページを自動で取得しに来るプログラムです。Googleの検索エンジンが使うGooglebotが代表で、AI各社も自社のクローラーを持っています。robots.txtは、サイトのルート(例:https://www.gym-ts.com/robots.txt)に置くテキストファイルで、「このクローラーはここを見ないでください」と伝える仕組みです。法的な強制力はなく、クローラー側が従うかどうかに委ねられています。
User-agentは、クローラーが名乗る名前です。robots.txtではこの名前ごとに許可・拒否を書きます。
AIクローラーは3種類ある
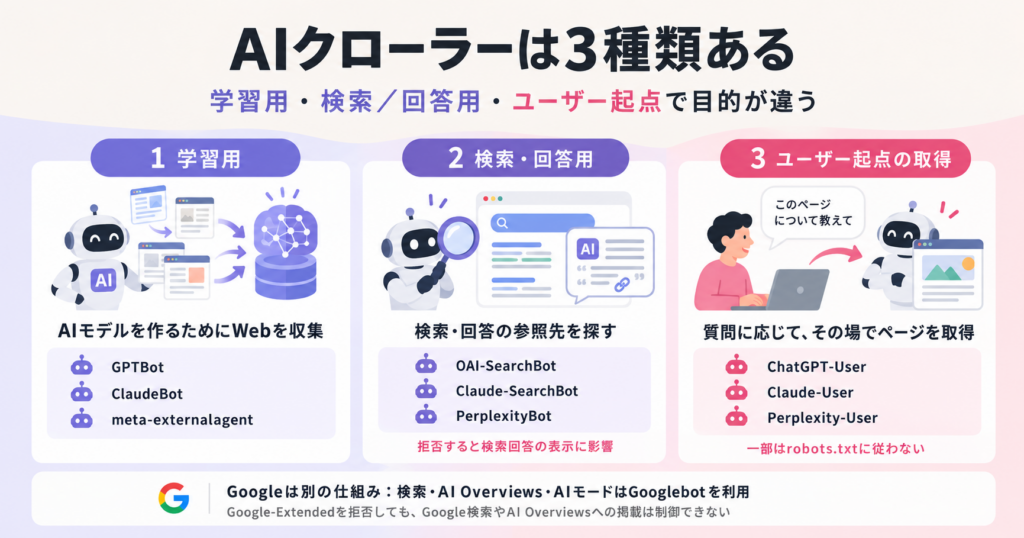
AI各社のクローラーは、目的によって3つに分かれます。この区別が、この記事で一番大事な部分です。
1つ目は学習用です。AIモデルを作るためのデータとしてWebを収集します。OpenAIのGPTBot、AnthropicのClaudeBot、Metaのmeta-externalagentがこれにあたります。
2つ目は検索・回答用です。ChatGPTやClaudeの検索機能で「どのサイトを回答の参照先にするか」を決めるために、検索インデックスを作ります。OpenAIのOAI-SearchBot、AnthropicのClaude-SearchBot、PerplexityのPerplexityBotがこれです。OpenAIは「OAI-SearchBotを拒否したサイトはChatGPTの検索回答に表示されない」と明記しています。
3つ目はユーザー起点の取得です。利用者がAIに質問して、AIがその場でページを見に行くときの名前です。ChatGPT-User、Claude-User、Perplexity-Userがこれで、ChatGPT-UserとPerplexity-Userは「人の操作の代行」という位置づけで、robots.txtに従わないと各社が公表しています。
Googleは少し違う構造です。Google検索、AI Overviews、AIモードはすべてGooglebotが取得したデータで動きます。Google-Extendedという別のトークンがありますが、これはGeminiアプリとVertex AIのモデル学習・グラウンディングへの利用を制御するもので、Googleは「Google-ExtendedはGoogle検索での掲載やランキングに影響しない」と明記しています。つまりGoogle-Extendedを拒否してもAI Overviewsには出続け、AI Overviewsに出したくなければGooglebot自体を制御するしかなく、それは通常の検索からも消えることを意味します。
| User-agent | 提供元 | 種類 | 拒否すると起きること | robots.txt |
|---|---|---|---|---|
| GPTBot | OpenAI | 学習用 | 学習データに使われなくなる。ChatGPT検索の表示には影響しない | 従う |
| OAI-SearchBot | OpenAI | 検索・回答用 | ChatGPTの検索回答に表示されなくなる | 従う |
| ChatGPT-User | OpenAI | ユーザー起点 | (利用者の操作なので制御対象外) | 従わない |
| ClaudeBot | Anthropic | 学習用 | 学習データに使われなくなる | 従う |
| Claude-SearchBot | Anthropic | 検索・回答用 | Claudeの検索結果に出なくなる | 従う |
| Claude-User | Anthropic | ユーザー起点 | 利用者の質問時にページを見に来なくなる | 従う |
| PerplexityBot | Perplexity | 検索・回答用(学習には不使用) | Perplexityの回答に出なくなる | 従う |
| Perplexity-User | Perplexity | ユーザー起点 | (利用者の操作なので制御対象外) | 従わない |
| Googlebot | 検索+AI Overviews+AIモード | Google検索からも消える | 従う | |
| Google-Extended | Gemini学習・グラウンディング制御 | Google検索・AI Overviewsには影響しない | 従う |
この表は2026年9月時点で各社が公開している仕様に基づきます。名前と挙動は変わるので、設定を変えるときは各社の公式ドキュメントを見直してください。
拒否すると何が起きるか
学習用だけを拒否した場合、自社のコンテンツが将来のモデルの学習に使われることは防げます。検索・回答用は動いているので、AIが「今」Webを検索して答えるときには引用されます。コーポレートサイトの多くにとって、これが現実的な落としどころです。
検索・回答用まで拒否した場合、そのAIの回答には自社が出てきません。第1回で書いた「比較検討の前工程がAIに寄る」状況では、競合だけが回答に並ぶことになります。コンテンツを守る対価として、これを受け入れるかどうかの判断です。
何も書かない場合、すべてのクローラーが来ます。当社サイトのrobots.txtは現時点でこの状態です。WordPressの管理画面だけを拒否し、AIクローラーについては何も書いていないので、学習用も検索用もすべて許可になっています。これは「決めていない」のではなく、コーポレートサイトの情報は広く知られてこそ価値がある、という判断で意図的にそうしています。
判断のフローチャート
サイトの中身を2つの軸で分けると、答えが決まります。
1つ目の軸は、その情報が「知られるほど得か、知られると損か」です。会社概要、事業内容、実績、採用情報、コラムは、知られるほど得な情報です。有料の会員向けコンテンツ、独自調査の生データ、未発表の製品情報は、知られると損をする情報です。
2つ目の軸は、「AIの回答に出てほしいか」です。BtoBで比較検討の土俵に乗りたいなら出てほしい。ブランドを厳密に管理していて、要約されて広まること自体を避けたいなら出てほしくない。
| AIの回答に出てほしい | 出てほしくない | |
|---|---|---|
| 知られるほど得な情報 | すべて許可(コーポレートサイトの大半) | 検索・回答用を拒否(まれ) |
| 知られると損な情報 | 学習用だけ拒否、検索・回答用は許可 | すべて拒否、またはログイン必須にする |
コーポレートサイト全体を一律に決める必要はありません。robots.txtはディレクトリ単位で書けるので、「会社情報とコラムは許可、有料コンテンツのディレクトリは学習用を拒否」のような組み合わせができます。
ひとつ注意があります。robots.txtは「お願い」なので、確実に守りたい情報はログインの内側に置くのが唯一の方法です。robots.txtで拒否したから安全、とは考えないでください。
記述例
学習用だけを拒否し、検索・回答用は許可する例です。
User-agent: GPTBot
Disallow: /
User-agent: ClaudeBot
Disallow: /
User-agent: meta-externalagent
Disallow: /
User-agent: Google-Extended
Disallow: /
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap: https://www.example.co.jp/sitemap.xml
特定のディレクトリだけ学習用を拒否する例です。
User-agent: GPTBot
Disallow: /members/
Disallow: /research-data/
User-agent: ClaudeBot
Disallow: /members/
Disallow: /research-data/
書き方の注意を3つ。User-agentの名前は大文字小文字を含めて正確に書く。ブロックはUser-agentごとに空行で区切る。「User-agent: 」の一括拒否は、Googlebotも止めてしまうので、AIを止めるつもりで書かないこと。過去にセキュリティ目的で「」を丸ごとDisallowにした設定が残っているサイトを見かけますが、それは検索エンジンからも消えている状態です。
確認方法
自社の現状は、ブラウザで https://自社ドメイン/robots.txt を開けば見られます。AIクローラーの名前が書かれていなければ、すべて許可の状態です。
実際にどのクローラーが来ているかは、サーバーのアクセスログでUser-agentを集計するとわかります。レンタルサーバーなら管理画面からログをダウンロードでき、GPTBot、ClaudeBot、PerplexityBotなどの文字列で検索すれば件数が出ます。当社サイトの直近1か月では[要データ:ログ集計後に記入。例:GPTBot ○回、ClaudeBot ○回、PerplexityBot ○回、OAI-SearchBot ○回]でした。学習用クローラーは検索用より頻繁に来る傾向があり、サーバー負荷が問題になる場合は、拒否ではなくCrawl-delayで間隔を空ける選択肢もあります(Anthropicは対応を公表しています)。
設定を変えた後は、Search Consoleの「robots.txtレポート」で構文エラーがないことを確認してください。AIクローラーへの影響はGoogleのツールでは検証できないので、変更後1か月のアクセスログで、拒否したクローラーが実際に減ったかを見ます。
まとめ
AIクローラーは学習用、検索・回答用、ユーザー起点の3種類で、拒否の対象を間違えると「学習には使われないのに、回答にも出ない」状態になります。コーポレートサイトの大半の情報は知られてこそ価値があるので、基本はすべて許可、守りたいディレクトリだけ学習用を拒否する。Google-Extendedを拒否してもAI Overviewsには影響しない。確実に守りたい情報はrobots.txtではなくログインの内側に置く。判断の軸は「知られると損か」「回答に出てほしいか」の2つで、会社の方針として決めておけば、新しいクローラーが出てきても同じ基準で対応できます。
コーポレートサイトの見直しを、株式会社ジムに相談しませんか
robots.txtは1行の書き間違いで検索エンジンからサイトが消えるファイルです。変更するなら、現状のログを見て、影響範囲を確認してからにしてください。
株式会社ジムは、1981年の創業から45年、2000年からWebサイトの制作に携わり、2013年からコーポレートサイト全体の設計・制作・運用を続けてきました。東証プライム上場企業を含む190社の企業サイトに携わり、継続取引歴10年以上の企業も9社あります。制作だけでなく、GA4・Search Consoleによる解析、広告運用、コンテンツ制作まで同じチームで担当しているため、「作って終わり」ではなく「作った後に選ばれ続ける」ところまで伴走できます。
「自社のrobots.txtがどうなっているか見てほしい」「AIクローラーがどれだけ来ているか知りたい」といった部分的なご相談も歓迎です。下記フォームからお問い合わせください。
改訂履歴
- v1.0(2026年9月21日)初版。クローラーの仕様はOpenAI「Overview of OpenAI Crawlers」、Anthropicヘルプ「Does Anthropic crawl data from the web」、Perplexity「Perplexity Crawlers」、Google「Google の一般的なクローラー」の2026年9月時点の記載に基づく